словарная статья
возможность
сущ., ж., мн. возможности
- Модуль платформы и задачи исследования, которые он решает.
- Статус: есть — работает в текущей версии, частично — основа есть, часть в разработке, в разработке — появится в следующих версиях.
§ 01 исследование есть
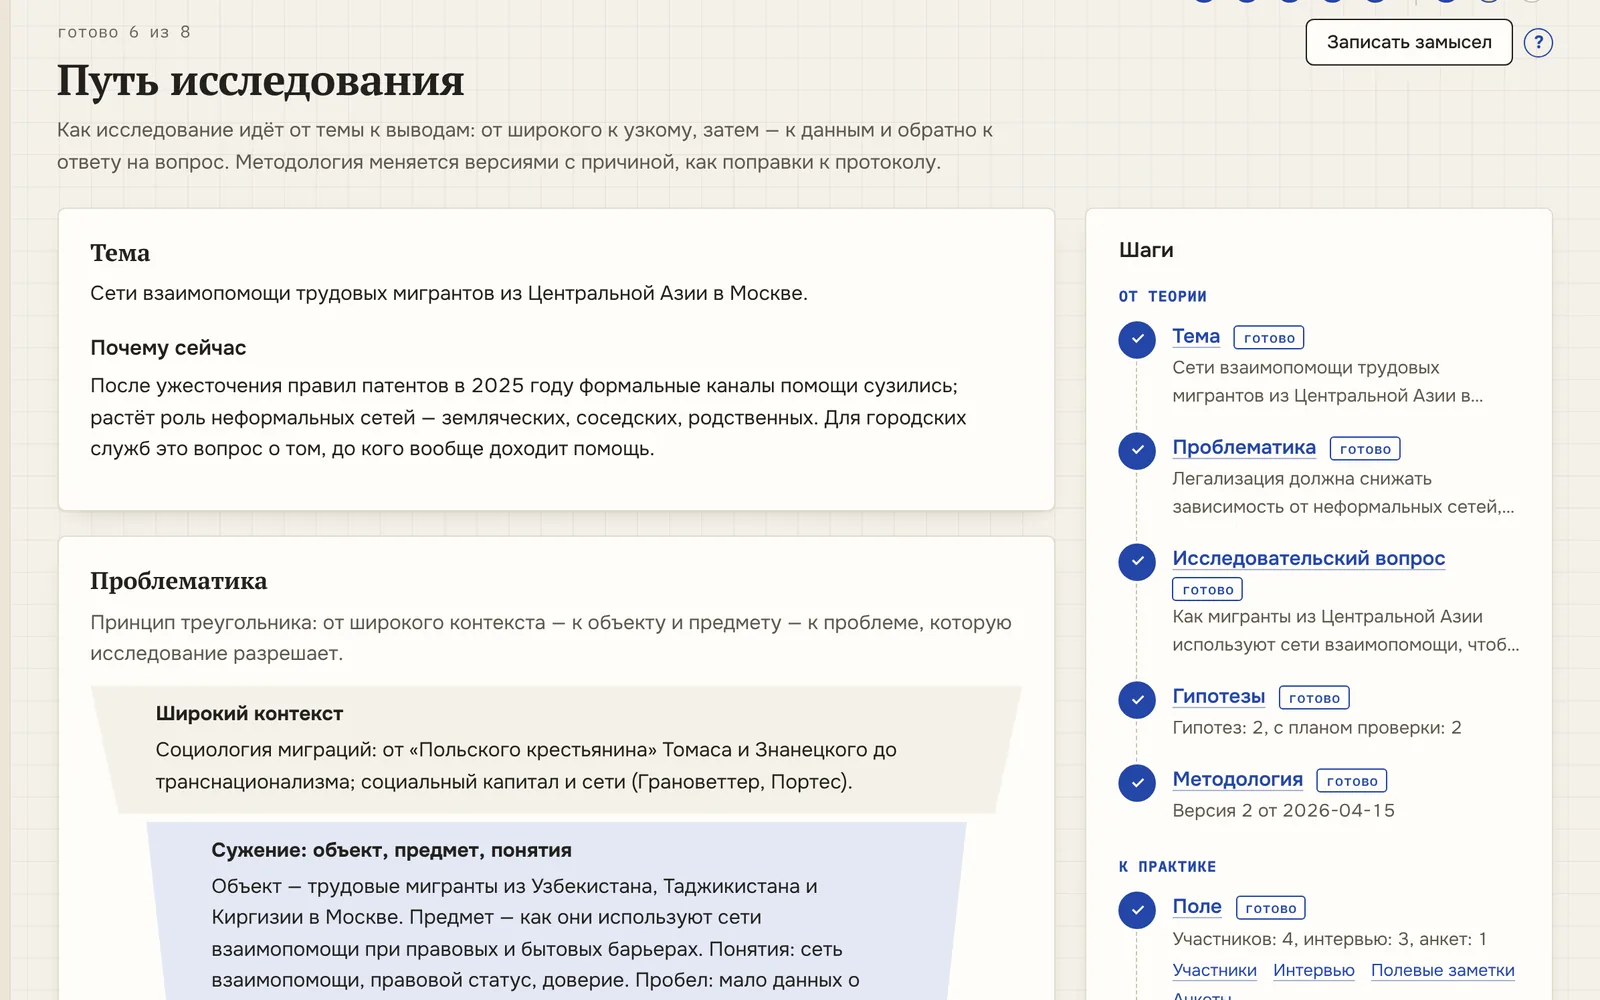
Путь исследования
Исследование выстроено по шагам: тема, проблематика, исследовательский вопрос, гипотезы, методология, поле, обработка и анализ, выводы. Состояние каждого шага считается по данным, а методология ведётся как протокол: каждое изменение сохраняется новой версией с причиной.
что умеет
- замысел: тема и актуальность, проблематика от широкого контекста к проблеме, исследовательский вопрос
- гипотезы с планом проверки, доказательствами «за» и «против» и статусом: подтверждается, подтверждается частично, не подтвердилась, переформулирована
- методология из семи разделов — подход, методы, выборка, инструменты, этика, план анализа, ограничения — версиями с причиной изменения
- состояние восьми шагов на обзоре исследования и ссылки туда, где делается каждый шаг
на выходе версии методологии · журнал решений
как это выглядит
§ 02 поле есть
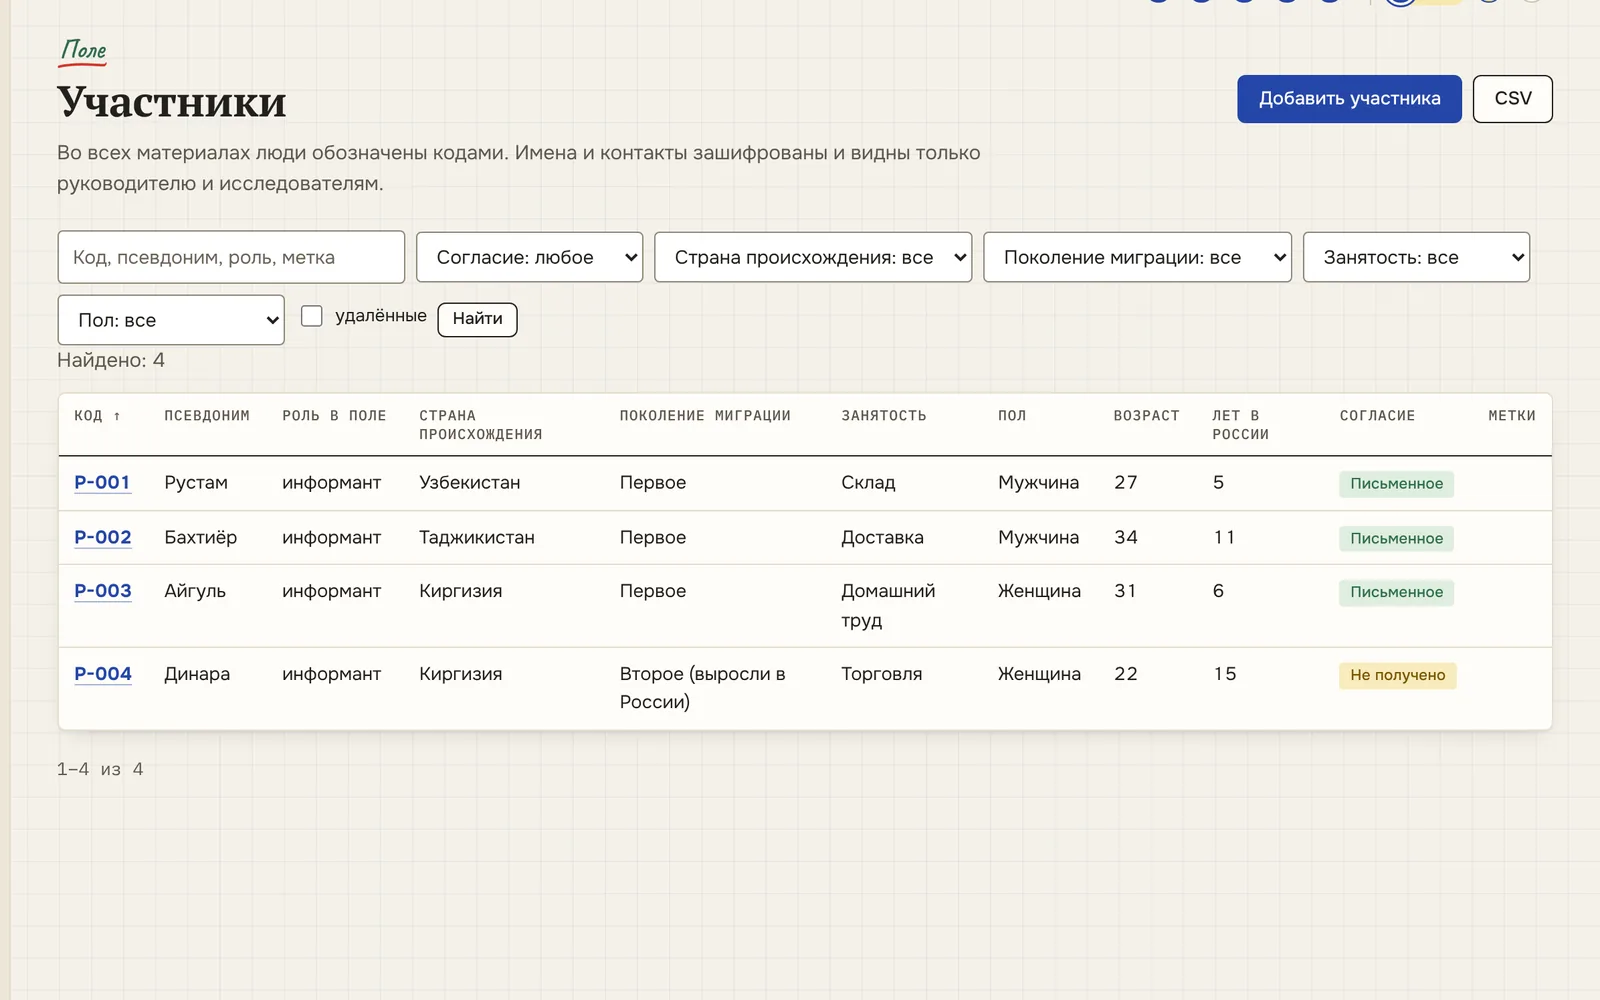
Участники и согласия
Реестр людей, с которыми работает исследование. Во всех материалах человек обозначен шифром (P-001) и, при желании, псевдонимом; имя и контакты хранятся отдельно, в зашифрованном виде. Здесь же ведётся учёт согласий и их отзыва.
что умеет
- шифры, псевдонимы, роль в поле и параметры исследования: регион, возраст, поколение
- статус согласия, дата и скан или запись согласия
- имя и контакты — в зашифрованном блоке; каждый просмотр записывается в журнал
- отзыв согласия исключает материалы участника из всех выгрузок, цитат, статистики и API
- удаление персональных данных по запросу участника
на выходе CSV без имён и контактов
как это выглядит
§ 03 поле есть
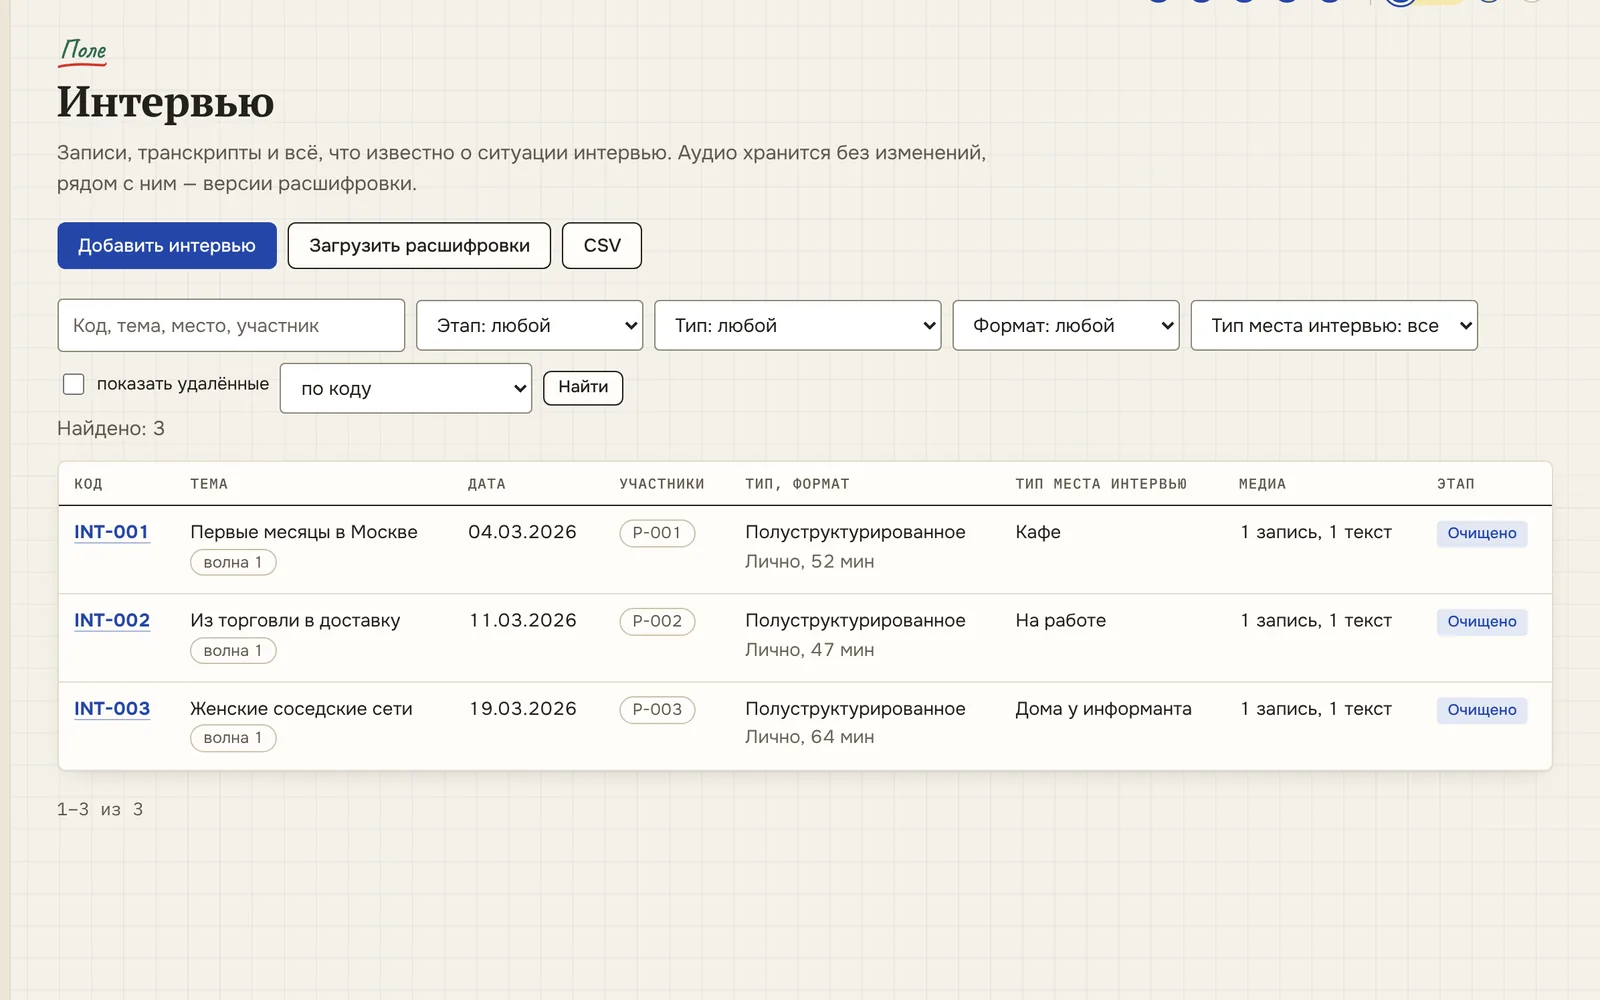
Интервью и транскрипты
Интервью хранится вместе со всем, что о нём известно: когда, где, с кем, кто вёл, какое согласие подписано. Транскрипт — не один файл, а цепочка версий: от сырой расшифровки до анонимизированной и переведённой.
что умеет
- метаданные встречи и участники под кодами P-001 с метками говорящих
- аудио и видео рядом с текстом; транскрипты из .txt, .docx, .srt, .vtt и JSON-вывода систем распознавания речи
- версии текста raw → очистка → нормализация → анонимизация → перевод, у каждой — рецепт
- сравнение двух версий: видно каждое изменённое слово
- имена и контакты участников зашифрованы, сканы согласий — только у двух ролей
на выходе corpus.jsonl · corpus.json · DOCX · Markdown
как это выглядит
§ 04 поле есть
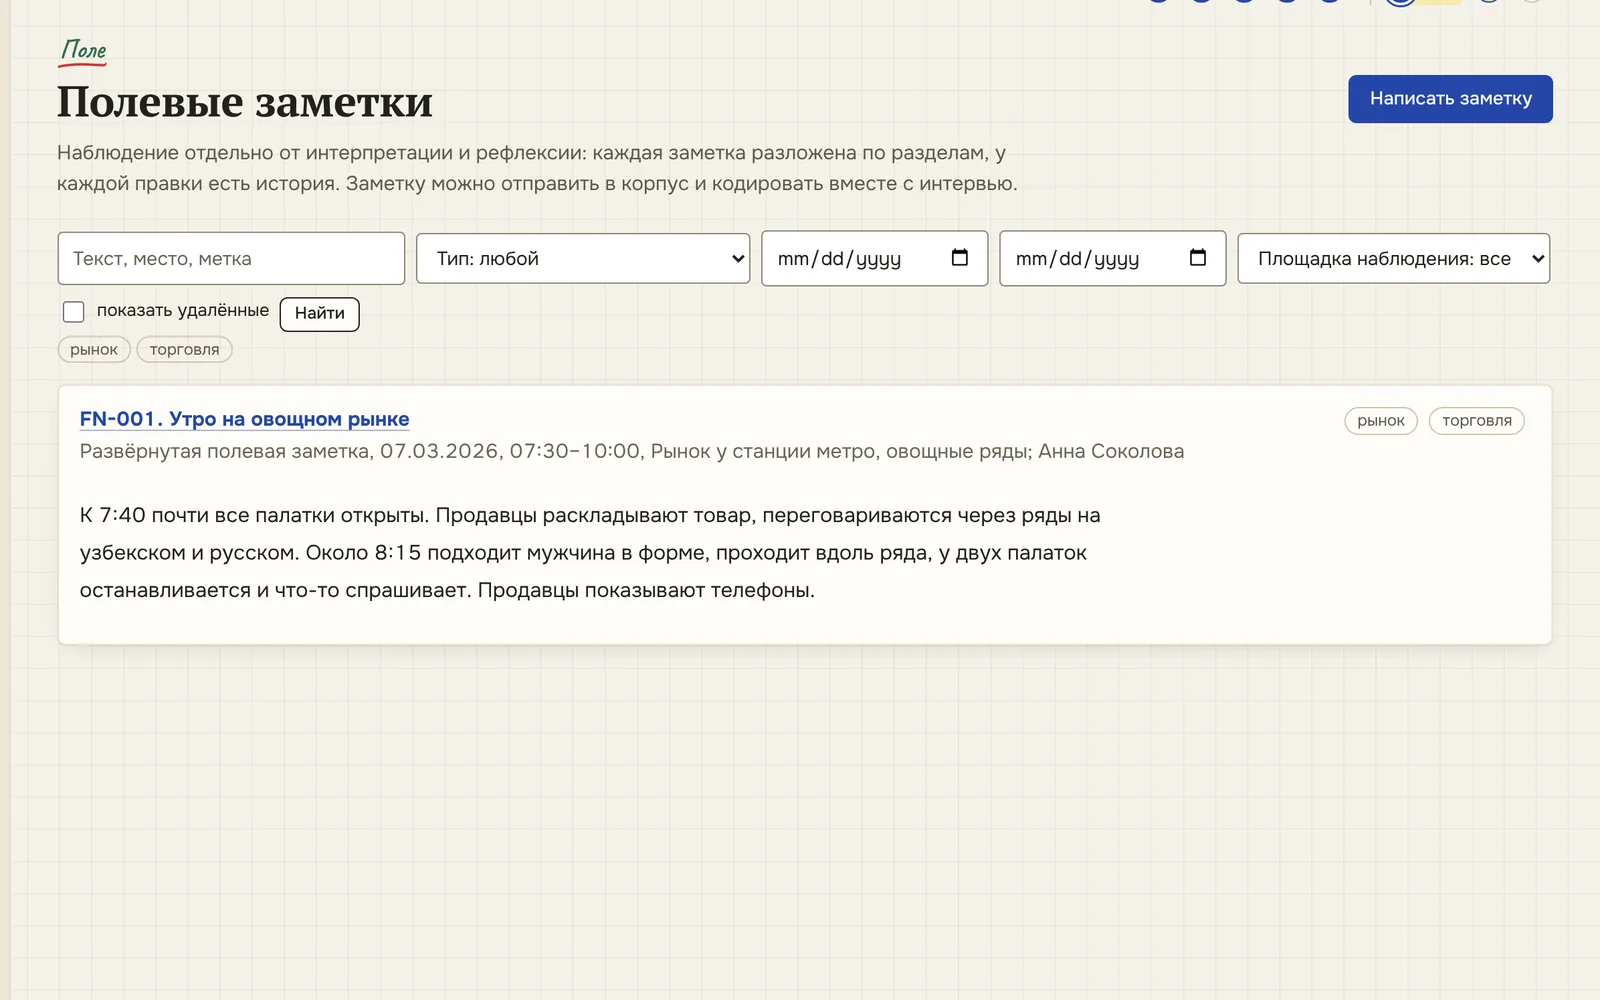
Полевые заметки и архив
Полевая заметка разделена так, как учат на методах и как редко делают в спешке: наблюдение отдельно, реплики отдельно, интерпретация и рефлексия — отдельно. Документы поля лежат в пронумерованных папках, как в мастер-файле клинического исследования.
что умеет
- разделы заметки: наблюдение, реплики, интерпретация, рефлексия, методология
- редакции заметки с историей: что было написано в поле и что дописано потом
- полевой архив: нумерованные папки, статусы документов, ревизии файлов
- фотографии с датой из EXIF, местом, связью с заметкой и отметкой «на снимке люди»
на выходе ZIP с описью · DOCX · исходные файлы
как это выглядит
§ 05 анализ есть
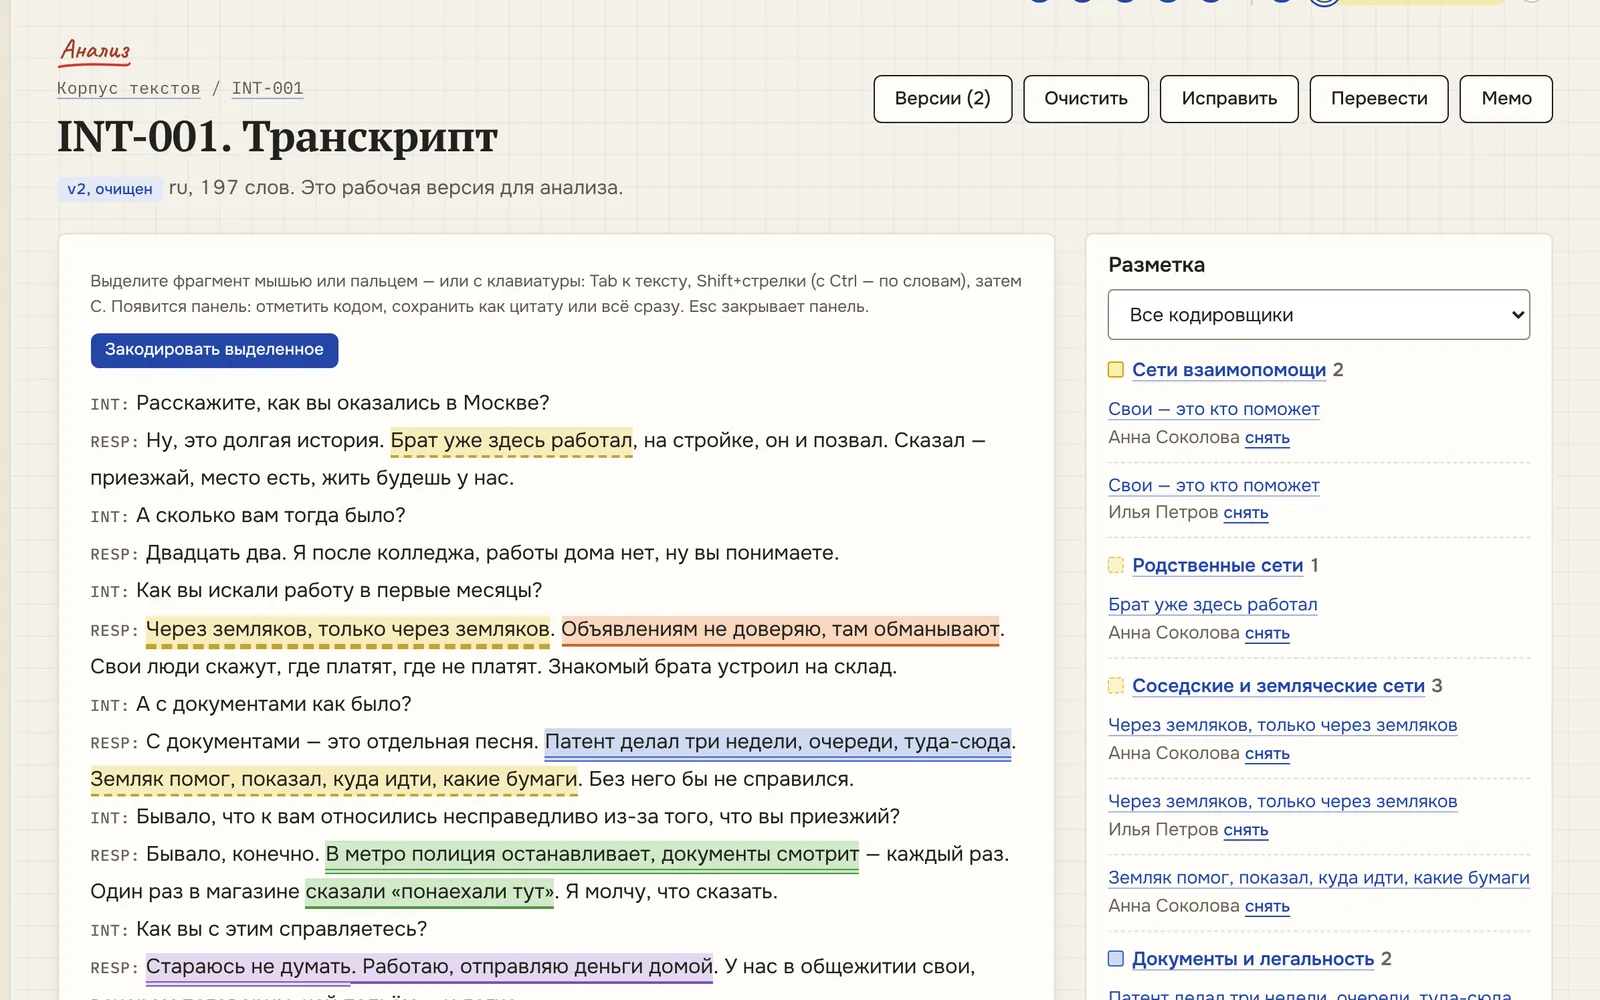
Кодирование и цитаты
Выделили фрагмент — отметили кодом или сохранили как цитату. Разметка привязана к версии текста и переезжает на следующую версию, а цитата помнит свой полный адрес: интервью, участник, версия, строка.
что умеет
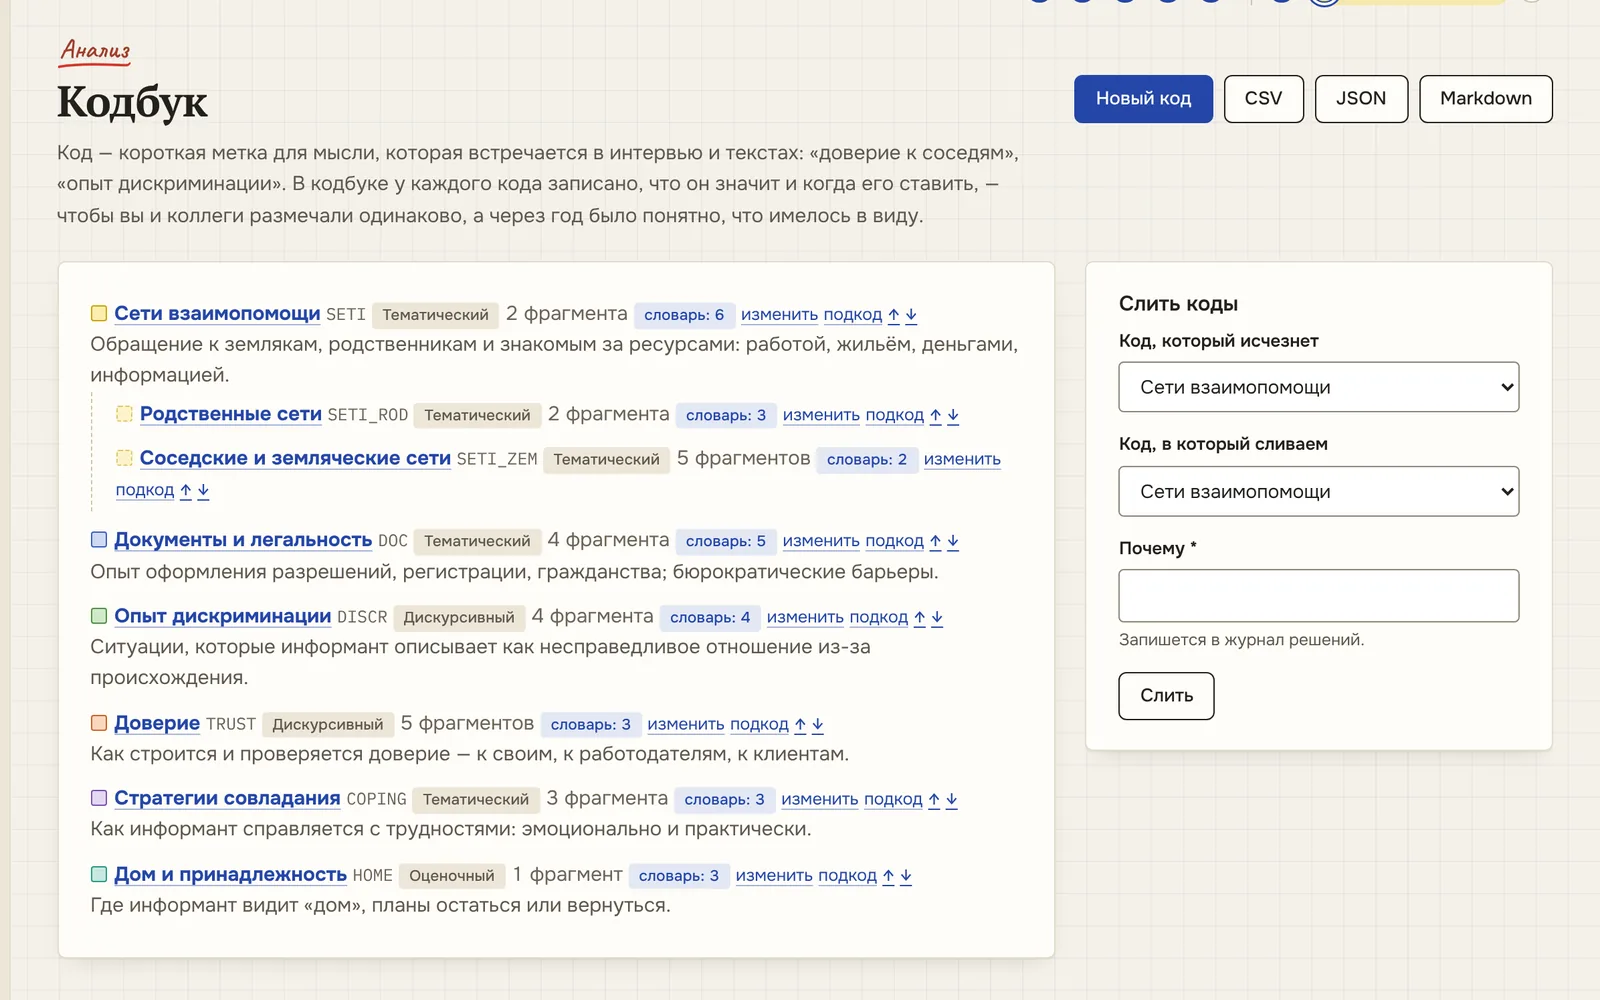
- кодбук: иерархия, определения, критерии включения и исключения, примеры
- слияние кодов с записью причины в журнал решений
- закономерности: коды × тексты, коды × группы, совместная встречаемость, слово в контексте
- согласие кодировщиков: каппа Коэна по двум разметкам
- цитаты и подборки под главы; гипотезы с доказательствами «за», «против» и «уточняет»
на выходе DOCX · Markdown · CSV · JSON
как это выглядит
§ 06 сети есть
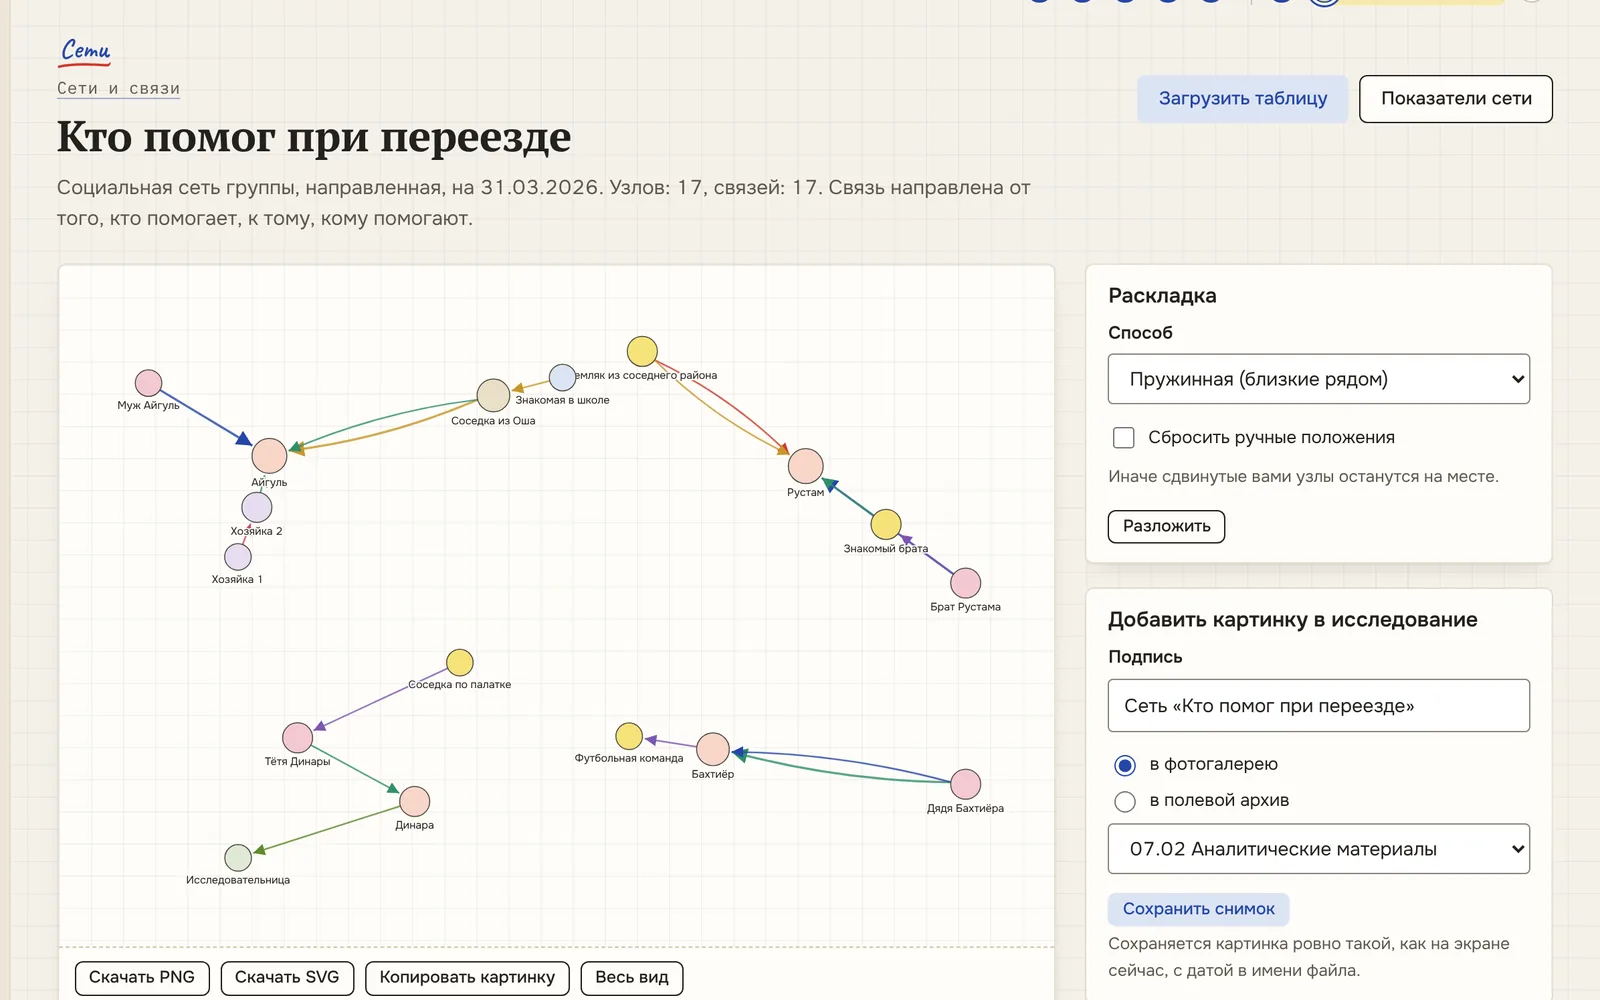
Сети
Таблица «индивид — тип связи — индивид 2» из XLSX, CSV или просто вставленная из буфера превращается в сеть, которую можно двигать руками, раскладывать, считать и сохранять картинкой прямо в полевой архив.
что умеет
- импорт списка связей или матрицы смежности; узлы из реестра участников
- раскладки: пружинная, Камада — Каваи, круг, по группам; перетаскивание сохраняется
- показатели: плотность, степень, посредничество, сообщества
- картинка в PNG и SVG, копирование в буфер, снимок в галерею или архив
- преобразования таблиц: список связей ↔ матрица, широкая ↔ длинная
на выходе PNG · SVG · GraphML · GEXF · матрица · R (igraph)
как это выглядит
§ 07 опросы и источники есть
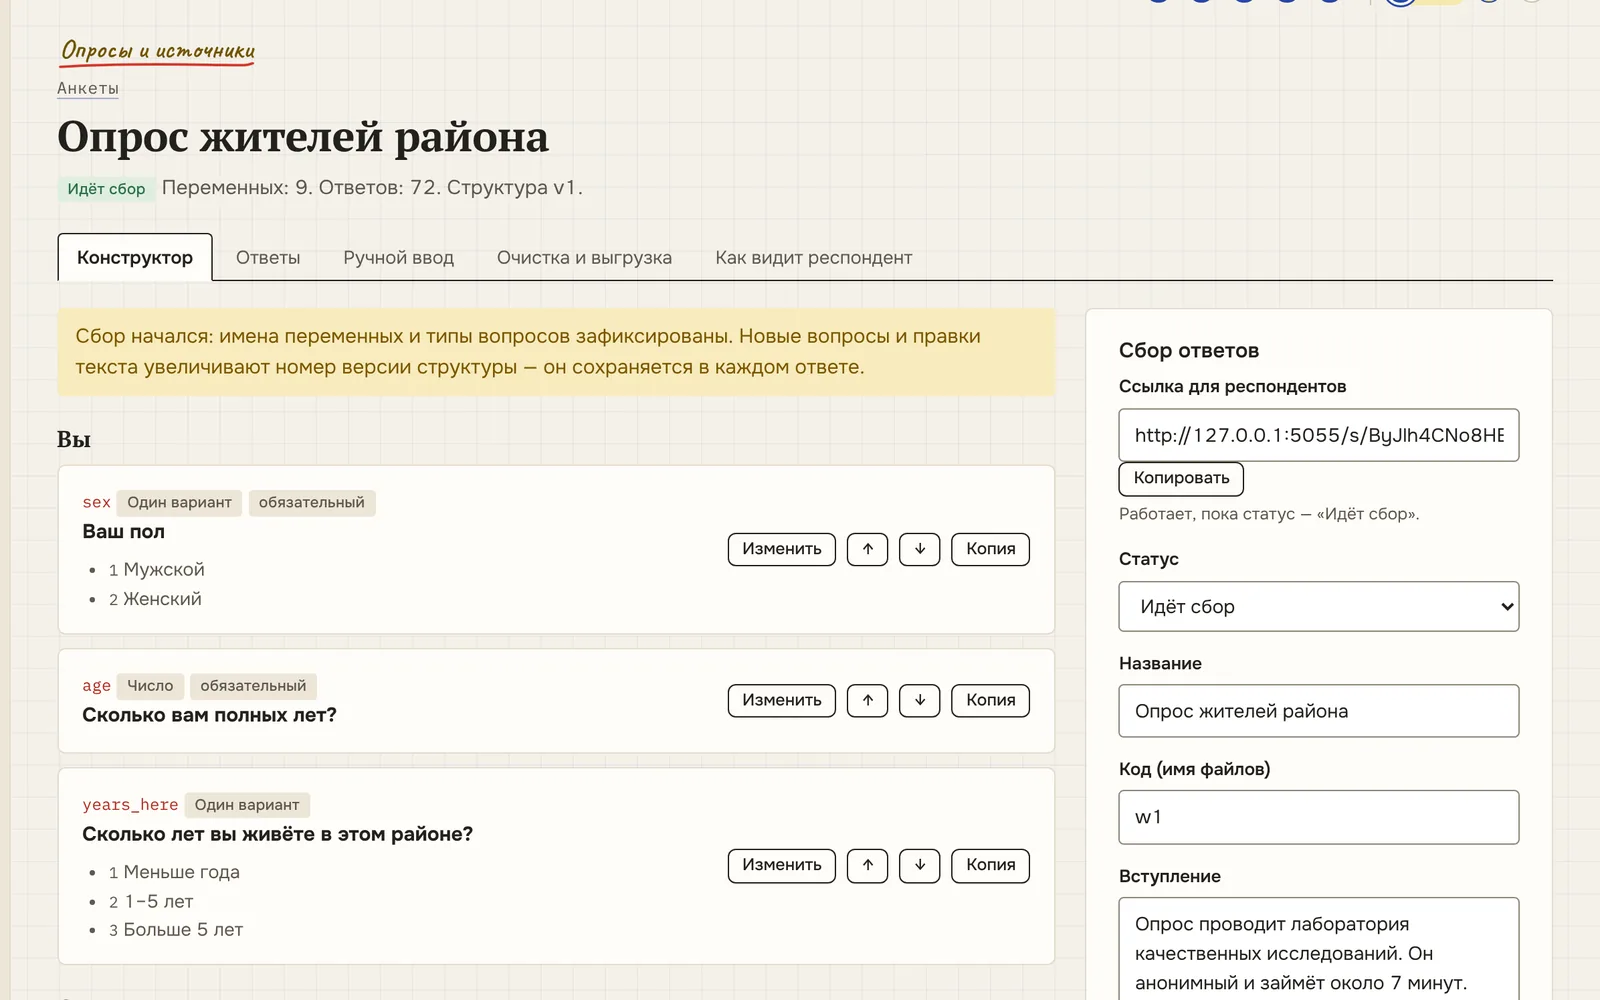
Анкеты и очистка для R
Анкету можно собрать прямо здесь или ввести бумажные ответы вручную. Сырые ответы не трогаются никогда: очистка — это список правил с причинами, который применяется заново при каждой выгрузке.
что умеет
- вопросы открытые и закрытые, шкалы, условия показа
- ссылка для респондентов и ручной ввод бумажных анкет
- правила очистки: пропуски, перекодировки, исправления, исключения, индексы — у каждого причина
- флаги качества: слишком быстро, прямолинейные ответы, противоречия
- выгрузка для R: CSV, словарь переменных и скрипт, который сам навешивает метки и факторы
на выходе CSV · словарь переменных · R-скрипт · XLSX
как это выглядит
§ 08 анализ есть
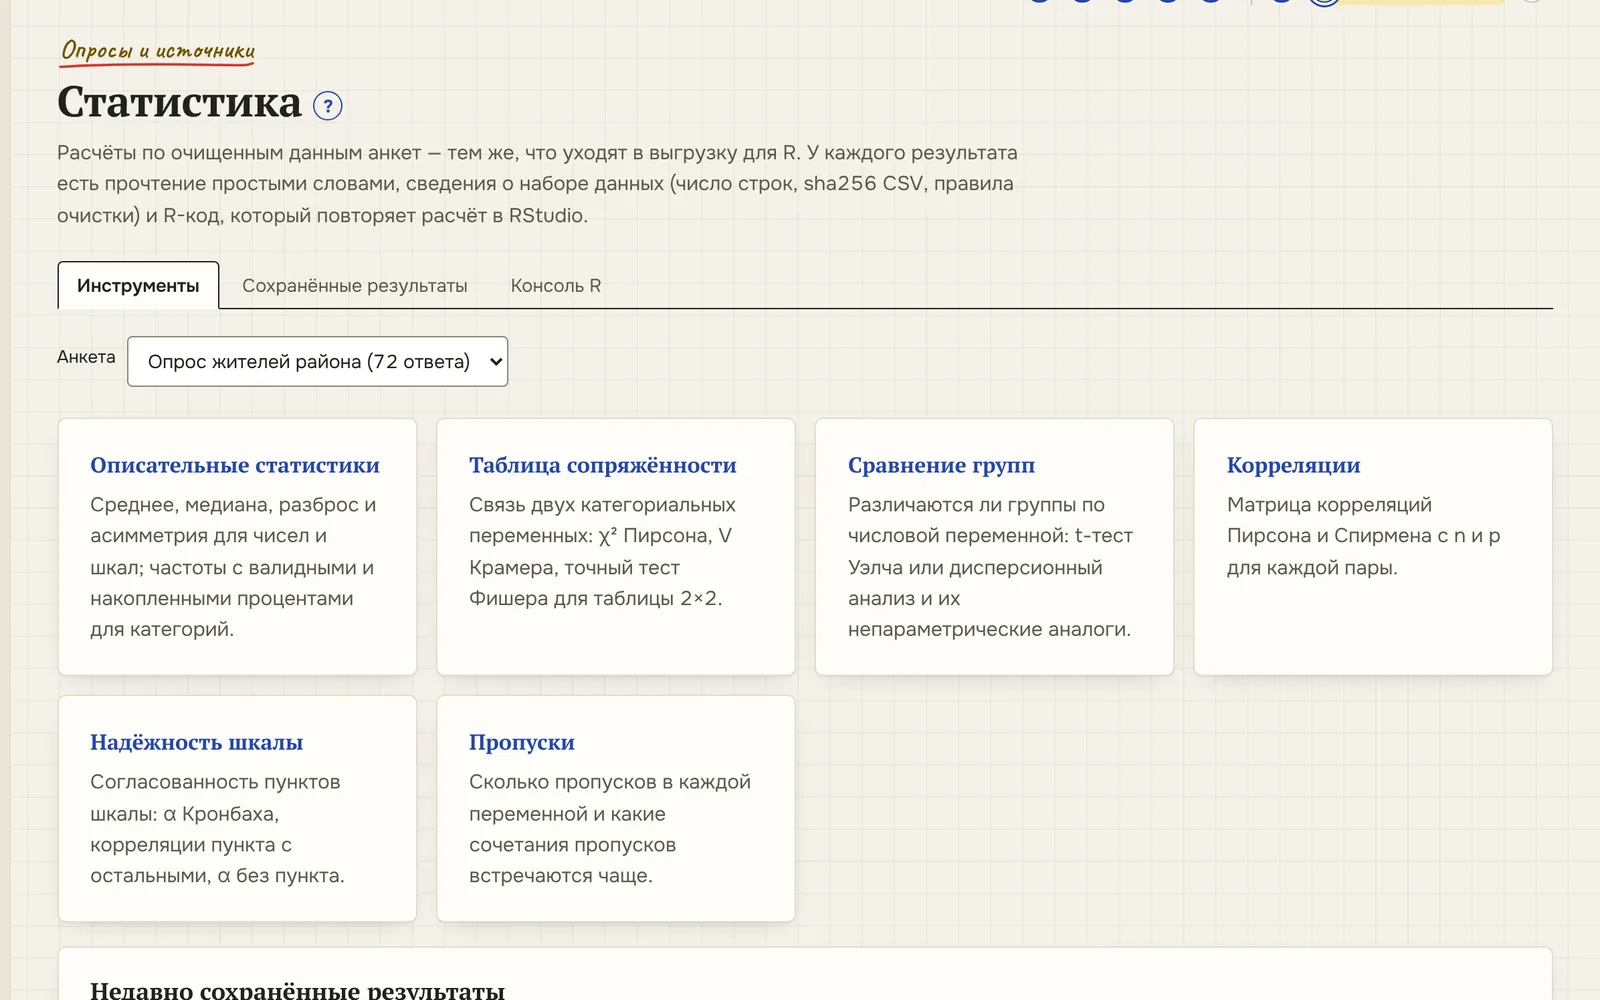
Статистика
Первые вопросы к данным — «сколько?», «у кого чаще?» — не должны требовать выгрузки в другую программу. Таблицы считаются по очищенным ответам и помнят, по какой версии правил они посчитаны. Для серьёзной модели по-прежнему лучше R — выгрузка для него уже есть.
что умеет
- частоты и описательные статистики по переменным анкеты
- таблицы сопряжённости по группам участников
- каждая таблица знает, на каких данных и правилах очистки она построена
на выходе CSV · XLSX
как это выглядит
§ 09 исследование есть
Словари
«Мск», «Москва» и «г. Москва» — три разных города для любой программы. Словари исследования хранят списки допустимых значений и правила замены, чтобы регионы, профессии и типы мест были записаны одинаково во всех интервью и анкетах.
что умеет
- списки значений для параметров исследования: регион, поколение, тип места
- словарь анонимизации: что и на что заменять в текстах
- словари для словарного кодера: слова и выражения, которые указывают на код
- перенос словарей между исследованиями вместе с шаблоном
на выходе CSV · JSON (шаблон исследования)
как это выглядит
§ 10 качество данных есть
Проверки и запросы
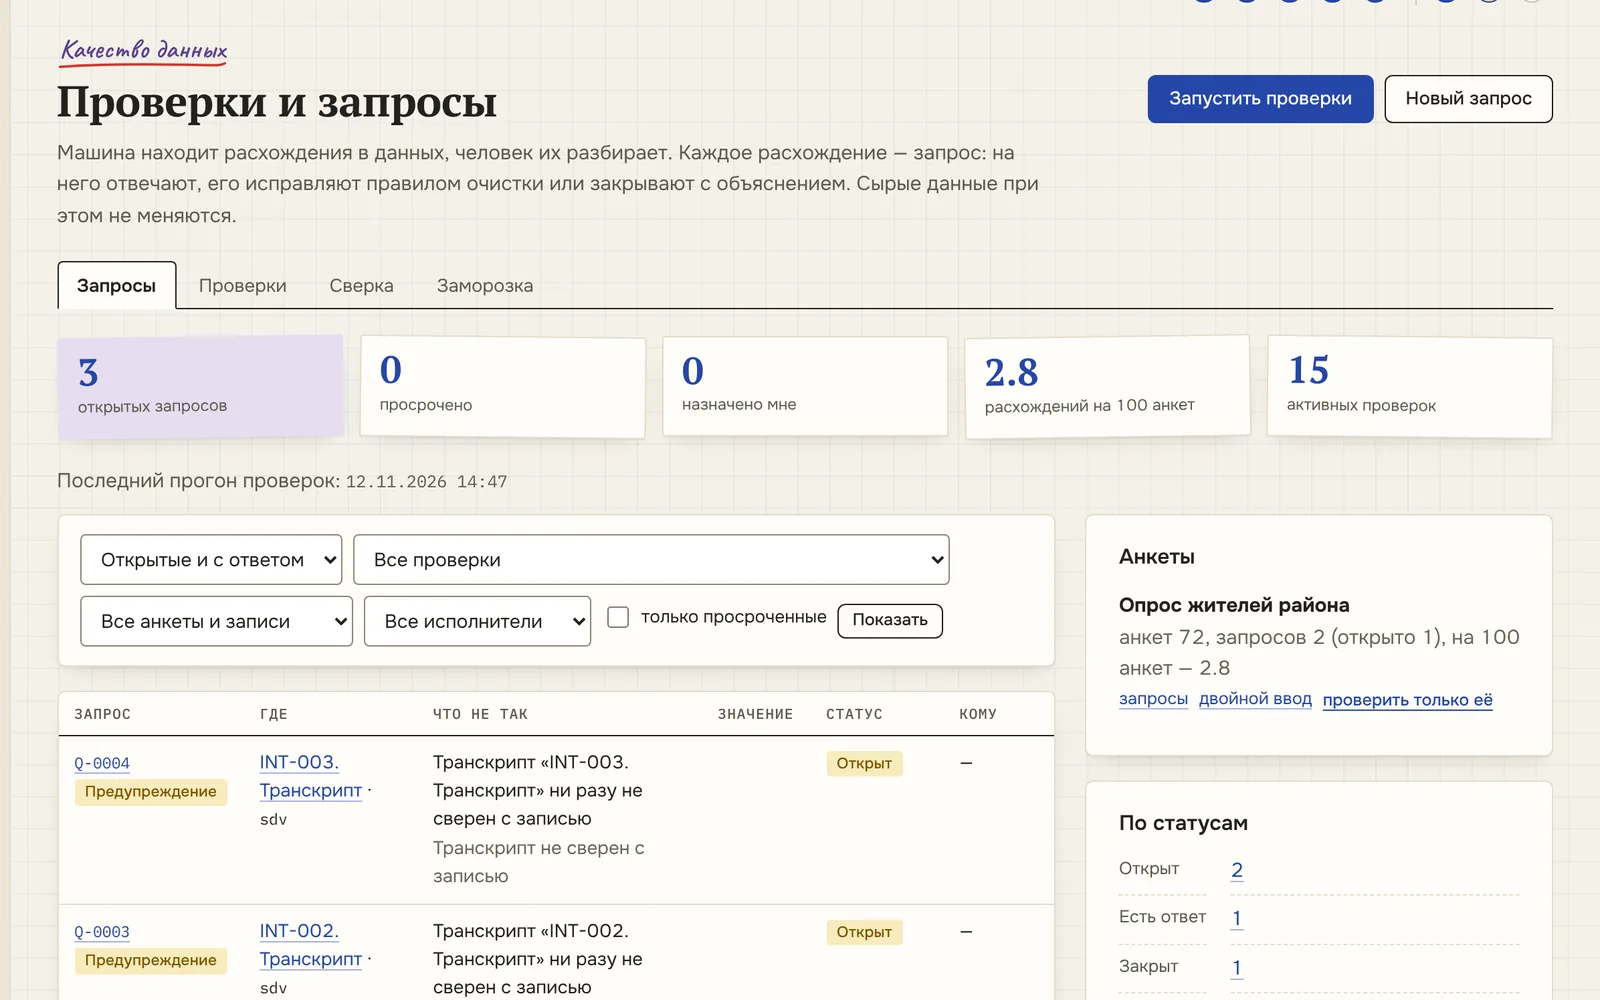
Приём из клинических исследований: данные проверяются правилами сразу при вводе, сомнительное значение превращается в вопрос автору, а перед анализом база замораживается. Так через год не приходится гадать, опечатка это или находка.
что умеет
- проверки при вводе (edit checks): диапазоны, обязательные поля, логические противоречия
- запросы (queries): вопрос к значению, ответ автора, закрытие — всё в истории
- двойной ввод бумажных анкет и сверка расхождений
- блокировка данных перед анализом: что заблокировано, кем и когда
на выходе отчёт о проверках · журнал запросов
как это выглядит
§ 11 опросы и источники есть
Библиография
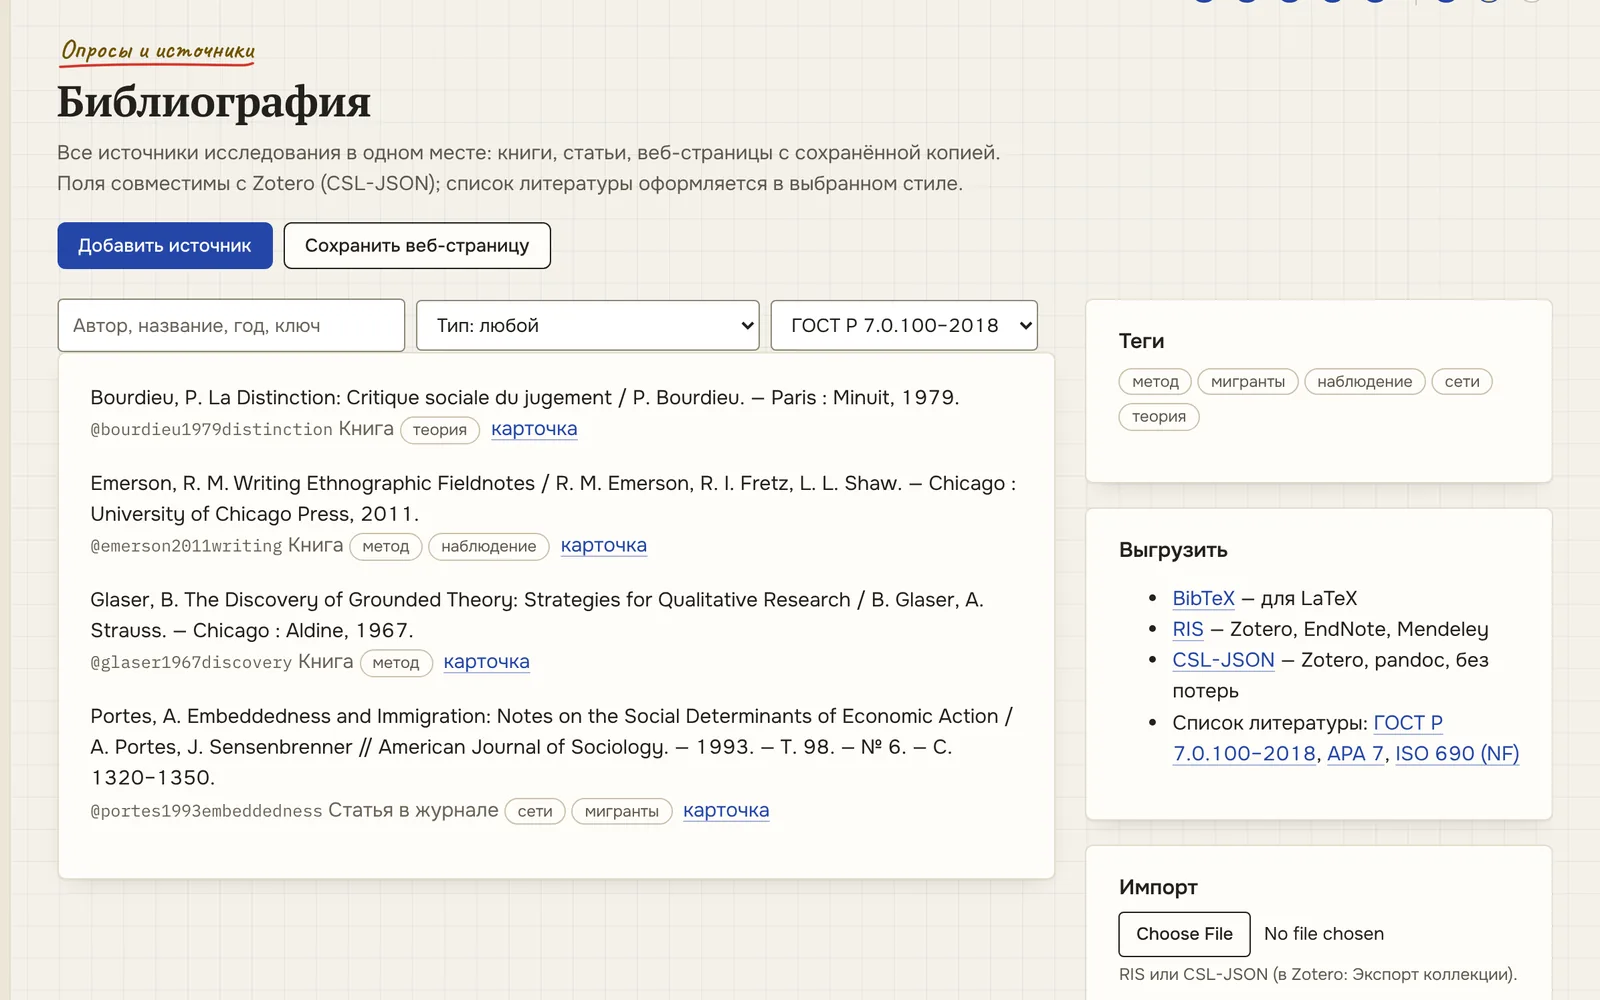
Источники живут рядом с данными: книгу, статью или веб-страницу можно привязать к цитате и мемо. Ручной ввод в полях CSL-JSON, импорт из менеджеров библиографии, сохранённая копия веб-страницы на случай, если она исчезнет.
что умеет
- ручной ввод, импорт RIS и CSL-JSON из менеджеров библиографии
- копия веб-страницы с датой обращения
- оформление по ГОСТ и APA; выгрузка BibTeX, RIS, CSL-JSON
на выходе BibTeX · RIS · CSL-JSON
как это выглядит
§ 12 качество данных есть
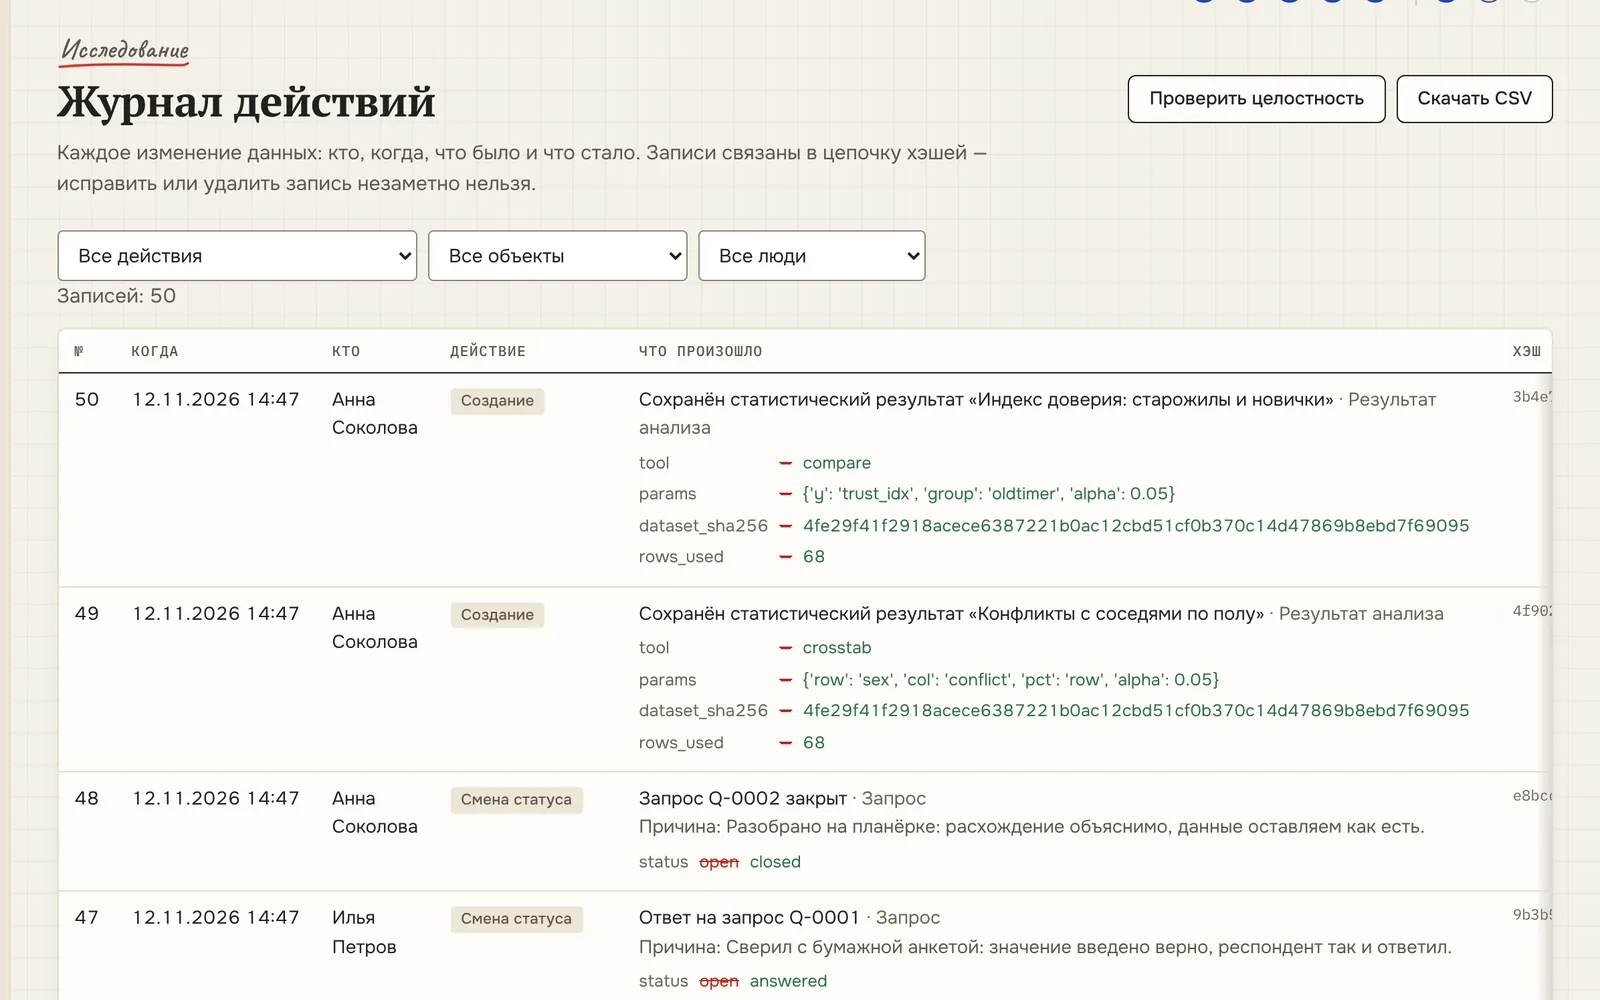
Журнал действий
Каждое создание, изменение, удаление, загрузка, выгрузка и просмотр имени участника записываются сами. Записи связаны хэш-цепочкой: если кто-то тихо поправит запись прямо в базе, проверка покажет место разрыва. Рядом — журнал решений, где исследователь пишет, почему.
что умеет
- журнал действий: пользователь, время сервера, поля «было» и «стало»
- хэш-цепочка и проверка целостности журнала и файлов
- журнал решений: «исключаем…, потому что…» — записи не удаляются
- пакет данных с описью и sha256 для архива или репозитория
на выходе ZIP (Frictionless Data Package) · sha256
как это выглядит
§ 13 исследование есть
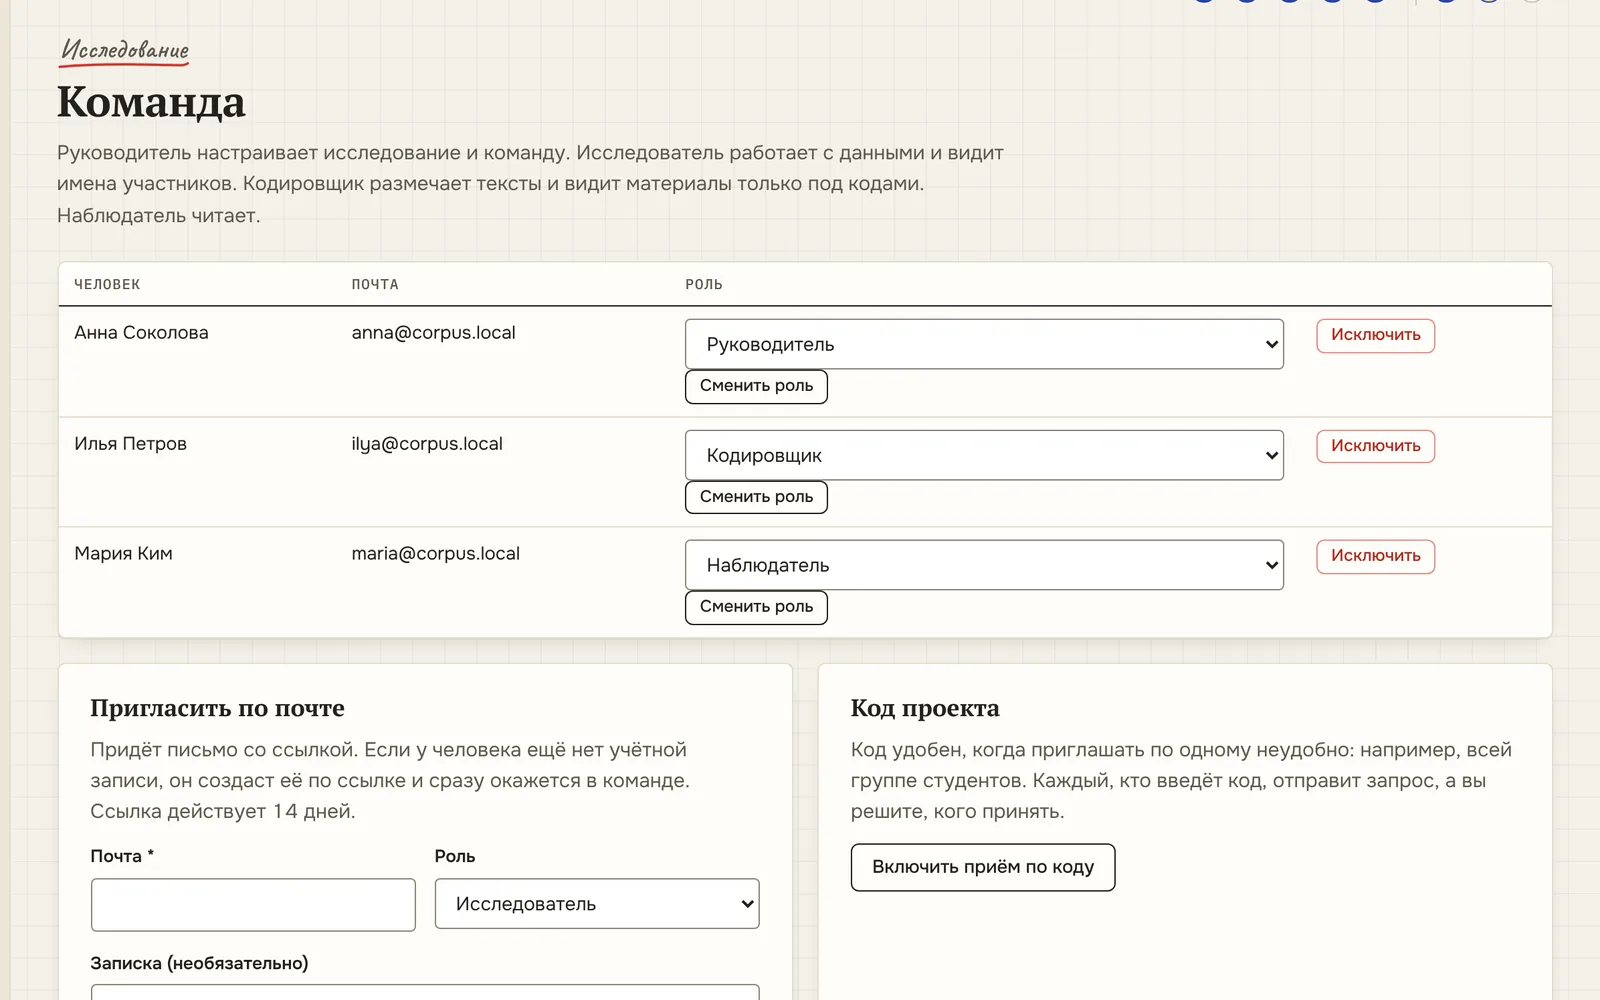
Совместная работа
Исследование редко делают в одиночку. У каждого в команде своя роль и свои права: кодировщик не видит имён участников, наблюдатель ничего не может испортить, а руководитель видит, кто что сделал.
что умеет
- роли: руководитель, исследователь, кодировщик, наблюдатель — права на каждой странице
- русский, английский и французский интерфейс; журнал каждому на его языке
- REST API по личным токенам — для своих скриптов в R и других языках
- уведомления; переписка по запросам качества данных
на выходе API · JSON
как это выглядит
§ дальше · планы
Чего пока нет
Функции, которых пока нет и о которых чаще всего спрашивают. Порядок их разработки определим по итогам пилота.
- обмен проектами с программами качественного анализа (открытый формат REFI-QDA);
- импорт и выгрузка анкет в форматах статистических пакетов (.sav, .dta) и DDI Codebook;
- синхронизация транскрипта с аудиозаписью по таймкодам;
- полевые заметки с телефона без подключения к интернету;
- автоматическая расшифровка и перевод через подключаемые сервисы;
- вход через университетскую учётную запись (Renater, eduGAIN).
предложения — сюда
Демо-доступ
В платформе есть демо-исследование «Трудовая миграция» с вымышленными данными: участники и согласия, интервью, анкета, сеть, кодирование и журнал действий. На нём можно проверить все описанные модули до переноса собственного исследования.